WISSEN > CLOUD INFRASTRUKTUR > DATEN ZWISCHEN CLOUD UN ON-PREMISES BEWEGERN
Migration, Replikation, Tiering und Backup technisch unterschieden
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Daten zwischen Cloud und On-Premises bewegen
Das sollten Sie mitnehmen:
- Datenbewegung ist nicht gleich Migration.
Migration, Replikation, Synchronisation, Tiering und Backup verfolgen unterschiedliche Ziele und erfordern unterschiedliche Verfahren.
- Die nominelle Bandbreite bestimmt die Transferdauer nicht allein.
Maßgeblich ist der gemessene End-to-End-Durchsatz über den gesamten Pfad von der Quelle bis zum Zielsystem.
- Die Änderungsrate entscheidet über den Erfolg.
Liegt sie über der erreichbaren Transferleistung, kann ein Delta-Abgleich den Rückstand nicht abbauen.
- Offline-Transfer ist eine Option, aber keine Abkürzung.
Kopierzeit, Logistik, Import und ein anschließender Delta-Abgleich müssen gegen den Netzweg gerechnet werden.
- Der Zielzustand muss vor dem Transfer feststehen.
Ob Daten einmal verlagert, repliziert, synchronisiert, ausgelagert oder gesichert werden, bestimmt jedes weitere Detail.

Inhaltsverzeichnis
- Hybride Architekturen besitzen zwangsläufig Datenpfade
- Migration, Replikation, Synchronisation, Tiering und Backup sind nicht dasselbe
- Die Datenmenge liefert nur die theoretische Untergrenze
- Viele kleine Dateien sind ein anderer Workload als wenige große
- Die Änderungsrate entscheidet, ob eine Migration aufholen kann
- Deshalb wird Datenbewegung in Phasen zerlegt
- Offline ist nicht automatisch schneller als online
- Erst die Konsistenzprüfung beendet eine Migration
- Der Transferpfad ist ein zusätzlicher Angriffspfad
- Der Rückweg gehört in dieselbe Planung
- Welches Verfahren zu welchem Ziel passt
- Welche Größen vor der Entscheidung bekannt sein müssen
- Fazit
- Quellen
Daten zwischen einer lokalen Infrastruktur und einer Cloud zu bewegen wirkt zunächst wie eine reine Übertragungsaufgabe. Technisch unterscheiden sich eine einmalige Migration, eine kontinuierliche Replikation, eine Synchronisation, Storage Tiering und Backup jedoch grundlegend voneinander.
Die entscheidende Frage lautet deshalb nicht nur, wie viele Daten übertragen werden müssen. Ebenso wichtig ist, warum sie bewegt werden, wie häufig sie sich ändern und welchen Zustand beide Seiten nach der Übertragung besitzen sollen.
Bei großen oder laufend veränderten Datenbeständen werden Netzwerkbandbreite, Latenz, Anzahl und Größe der Dateien oder Objekte, Änderungsrate, Parallelisierung, Konsistenzanforderungen und mögliche Transferkosten damit zu Architekturparametern.
1. Hybride Architekturen besitzen zwangsläufig Datenpfade
Hybride Infrastrukturen verbinden unterschiedliche Standorte und administrative Domänen. Cloud Storage kann darin Ziel einer Migration sein, zusätzliche Datenkopie, Backup-Ziel oder Storage Tier.
Ebenso relevant ist die Gegenrichtung. Daten können aus einer Cloud zurück in ein eigenes Rechenzentrum, zu einem anderen Anbieter oder auf eine andere Storage-Plattform übertragen werden.
Die Portabilität von Daten gehört damit zur Cloud-Architektur und ist kein Sonderfall. Die Cloud Data Management Interface (CDMI) der SNIA, standardisiert als ISO/IEC 17826:2022, adressiert unter anderem interoperables Datenmanagement und Datenportabilität für Cloud-, Hybrid- und On-Premises-Storage.
Zuvor ist jedoch zu klären, welche Form der Datenbewegung überhaupt benötigt wird.
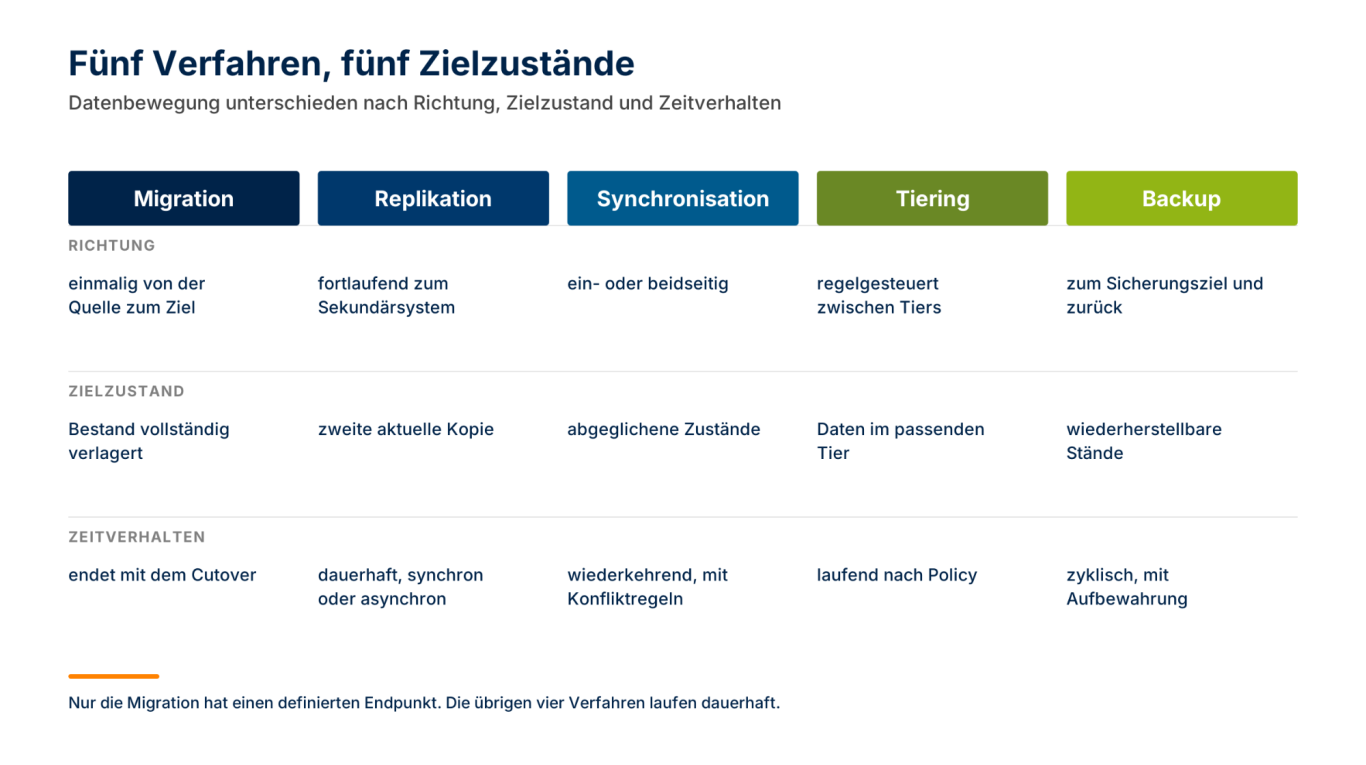
2. Migration, Replikation, Synchronisation, Tiering und Backup sind nicht dasselbe
Migration verlagert einen Datenbestand einmalig
Eine Migration überführt einen definierten Datenbestand von einem Quell- in ein Zielsystem. Der typische Ablauf besteht aus Initialtransfer, Delta-Abgleich, Validierung und Cutover.
Bei aktiven Datenbeständen liegt die Schwierigkeit darin, dass sich die Quelle während der Übertragung weiter verändert. Dauert ein Initialtransfer mehrere Tage, können Dateien oder Objekte aus der Anfangsphase bei Abschluss bereits überholt sein. Ein tragfähiges Migrationsverfahren muss solche Änderungen deshalb erkennen und nachführen oder Schreibzugriffe während einer definierten Phase unterbinden.
Der Initialtransfer allein ist damit keine abgeschlossene Migration.
Replikation erzeugt eine fortlaufende Kopie
Replikation verfolgt ein anderes Ziel. Die SNIA definiert Data Replication als kontinuierliche Aufrechterhaltung einer Datenkopie, gegebenenfalls an einem entfernten Standort, unter anderem für Redundanz, Hochverfügbarkeit oder Disaster Recovery.
Zu unterscheiden ist dabei zwischen synchroner und asynchroner Replikation. Bei synchroner Replikation muss ein Schreibvorgang laut SNIA sowohl am primären als auch am sekundären Standort auf stabilem Storage committed sein, bevor er gegenüber dem Host bestätigt wird. Der entfernte Schreibpfad wird damit Bestandteil der Write-Latency.
Bei asynchroner Replikation genügt der Commit am primären Standort für die Bestätigung. Die Daten werden anschließend entsprechend den verfügbaren Netzwerkressourcen zum Sekundärsystem übertragen. Zwischen beiden Systemen kann deshalb zeitweise ein unterschiedlicher Datenstand bestehen.
Replikation ist außerdem kein Backup. Wird eine unerwünschte Änderung repliziert, erreicht sie auch die Replik. Für die Wiederherstellung früherer Zustände sind zusätzliche Mechanismen nötig. Die SNIA führt dafür den eigenständigen Begriff Continuous Data Protection: eine Klasse von Mechanismen, die Datenänderungen fortlaufend erfassen oder nachverfolgen und dadurch eine Wiederherstellung auf frühere Zeitpunkte ermöglichen.
Synchronisation gleicht Zustände ab und muss Konflikte auflösen
Bei einer Synchronisation werden Zustände zwischen Systemen verglichen und Änderungen übertragen. Das kann einseitig erfolgen oder, abhängig von der Implementierung, in beide Richtungen.
Bidirektionale Verfahren werfen eine zusätzliche Frage auf: Was geschieht, wenn dasselbe Datenelement an mehreren Stellen verändert wurde? Dann werden eine Konflikterkennung und Regeln für die Konfliktauflösung benötigt.
Synchronisation ist damit mehr als regelmäßiges Kopieren. Sie setzt eine Festlegung voraus, anhand welcher Informationen Änderungen erkannt werden und welcher Zustand im Konfliktfall gilt.
Tiering bewegt Daten nach Regeln zwischen Storage-Klassen
Storage Tiering verfolgt wiederum ein anderes Ziel. Die SNIA definiert Automated Storage Tiering als automatische Bewegung von Daten zwischen Storage Tiers auf Basis von Policies. Diese Tiers können sich über unterschiedliche Storage-Systeme erstrecken, einschließlich eines Cloud Storage Tier.
Typisch ist deshalb keine vollständige Kopie eines Systems auf ein zweites, sondern eine regelgesteuerte Bewegung einzelner Datenelemente zwischen einem schnellen Tier und einem Kapazitäts- oder Cloud-Tier. Welche Daten bewegt werden, hängt etwa von Zugriffsmustern oder anderen definierten Kriterien ab. Die SNIA beschreibt Tiered Storage entsprechend als mehrere Storage-Klassen, zwischen denen Daten abhängig von Zugriff oder anderen Kriterien verschoben werden.
Für Anwendungen und Benutzer stellt sich zusätzlich die Frage, wie ausgelagerte Daten wieder verfügbar werden und wie stark ein Recall die Zugriffszeit verändert.
Backup bewegt Daten mit Recovery-Zweck
Auch Backup bewegt Daten, verfolgt damit aber die spätere Wiederherstellung. Entscheidend sind deshalb nicht nur Transfereigenschaften, sondern die verfügbaren Wiederherstellungspunkte, die aufbewahrten Datenstände, der Schutz der Sicherungen, der Rückweg der Daten und die Frage, ob eine Wiederherstellung tatsächlich getestet wurde.
NIST SP 800-209 behandelt Backup und Replication als Bestandteile der Data Protection von Storage-Infrastrukturen und führt in der finalen Fassung von 2020 unter anderem Restoration Assurance als eigenes Sicherheitsfeld.
3. Die Datenmenge liefert nur die theoretische Untergrenze
Die Überschlagsrechnung beschreibt einen Idealfall
Für einen ersten Überschlag lässt sich die minimale Übertragungszeit aus Datenmenge und effektivem Durchsatz berechnen. Bei einer idealisierten Verbindung mit 1 Gbit/s ergeben sich für 1 TB dezimal 8.000 Gbit und damit 8.000 Sekunden, also rund 2,2 Stunden.
Dieser Wert ist eine theoretische Untergrenze bei kontinuierlicher vollständiger Auslastung. Er berücksichtigt weder Protokoll-Overhead noch Paketverluste, konkurrierenden Verkehr, Verarbeitungszeiten oder Limits der beteiligten Systeme.
Der gesamte Pfad begrenzt den Durchsatz, nicht der Anschluss
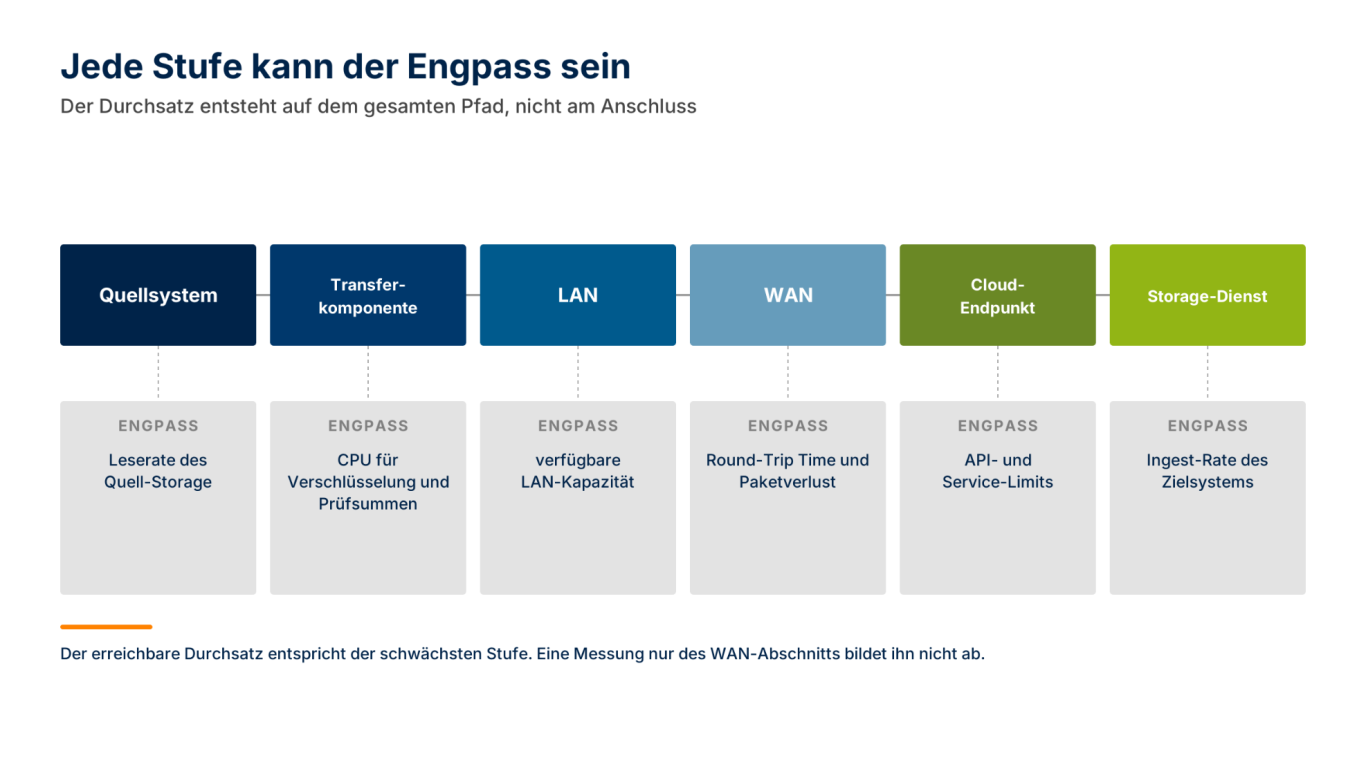
Zwischen Storage-Quelle und Storage-Ziel liegt ein vollständiger Datenpfad aus Quellsystem, Transferkomponente, LAN, WAN, Cloud-Endpunkt und Storage-Dienst. Jede Stufe kann zum begrenzenden Faktor werden.
Auf TCP-basierten Verbindungen wirken zusätzlich Transportmechanismen auf den erreichbaren Durchsatz. RFC 6349 beschreibt unter anderem den Zusammenhang zwischen Round-Trip Time, Bottleneck Bandwidth, Bandwidth-Delay Product sowie TCP Send- und Receive Windows. RFC 5166 behandelt Durchsatz, Delay und Paketverluste als miteinander verbundene Metriken für CongestionControl.
Eine hohe Bandbreite lässt sich über größere Distanzen deshalb nur nutzen, wenn der gesamte Übertragungspfad dafür ausgelegt ist. Praktisch relevant sind die tatsächlich verfügbare Bandbreite, Round-Trip Time und Paketverluste, die Anzahl paralleler Transfers, das Verhalten von TCP und Anwendung, die Leserate des Quellsystems, die Ingest-Rate des Zielsystems, der CPU-Aufwand für Verschlüsselung und Prüfsummen sowie API- und Service-Limits.
Eine Messung sollte deshalb den vollständigen Pfad einbeziehen und nicht bei einem isolierten Bandbreitentest stehen bleiben.
4. Viele kleine Dateien sind ein anderer Workload als wenige große
Zwei Datenbestände mit jeweils 10 TB verhalten sich beim Transfer nicht zwangsläufig gleich. Der eine kann aus wenigen sehr großen Dateien bestehen, der andere aus Millionen kleiner.
Große, sequenziell übertragene Datenobjekte erzeugen lange Datenströme. Bei sehr vielen kleinen Dateien fallen dagegen ungleich häufiger Operationen für Dateizugriff, Metadaten, Namespace-Verarbeitung, Protokolltransaktionen und die Erzeugung von Zielobjekten an.
Eine Migrationsplanung sollte deshalb zwei Größen getrennt betrachten: das Datenvolumen und die Anzahl beziehungsweise Größenverteilung der Datenelemente.
In Projekten sehen wir regelmäßig, dass ein Durchsatztest mit wenigen großen Testdateien einen Produktionsbestand aus sehr vielen kleinen Dateien nicht repräsentativ abbildet. Wir behandeln die Vorab-Analyse der Größenverteilung deshalb als Pflichtbestandteil der Planung.
5. Die Änderungsrate entscheidet, ob eine Migration aufholen kann
Bei einem statischen Archiv bleibt die Datenmenge weitgehend konstant. Bei aktiven Fileservices, Datenbanken oder anderen produktiven Systemen entstehen während des Transfers laufend neue Änderungen.
Vereinfacht lässt sich die Lage als Verhältnis zweier Größen beschreiben: der erreichbaren Transferleistung und der Änderungsrate. Damit ein nachgelagerter Delta-Abgleich einen Rückstand abbauen kann, muss die dauerhaft erreichbare Transferleistung unter sonst gleichen Bedingungen größer sein als die Datenmenge, die pro Zeiteinheit nachzuführen ist.
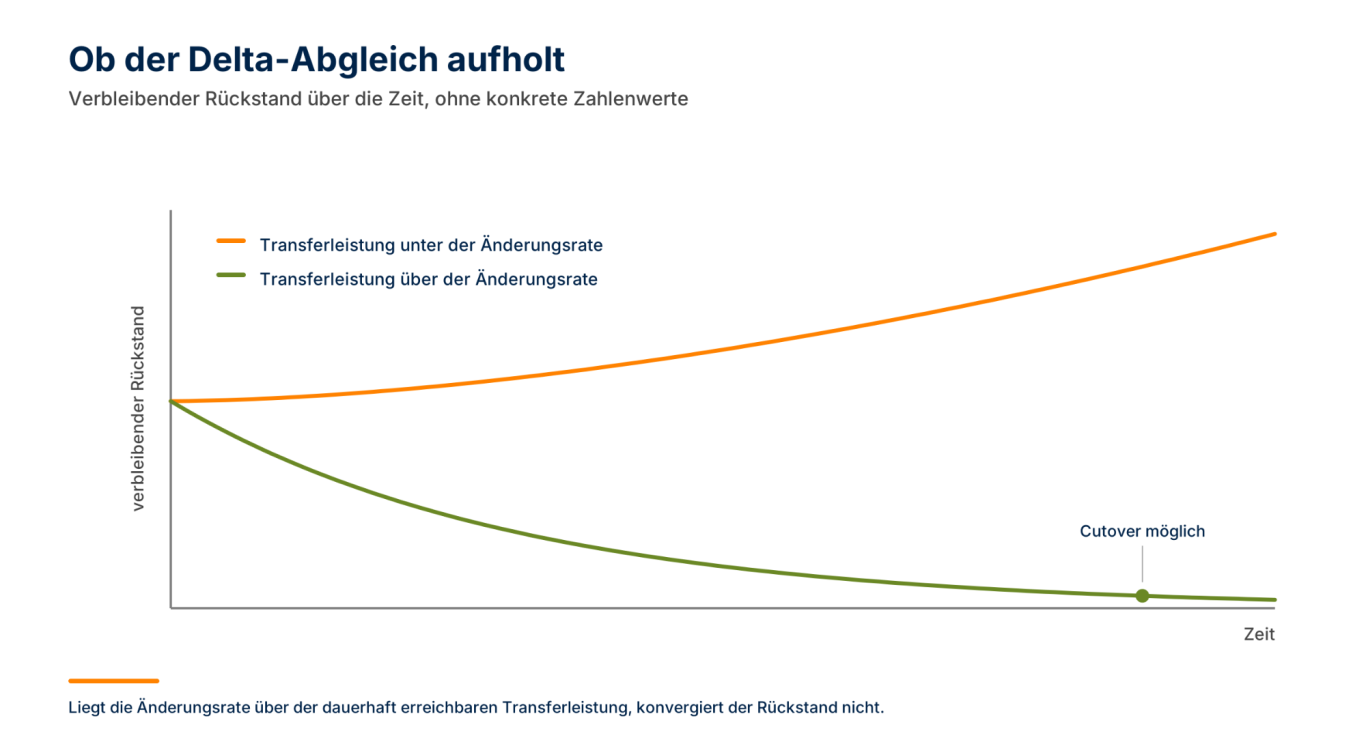
Bleibt die Übertragungsleistung unter der Änderungsmenge, konvergiert der Rückstand durch kontinuierlichen Delta-Transfer nicht. Darin liegt der wesentliche Unterschied zwischen der Migration eines statischen Datenbestands und der eines produktiv genutzten Systems.
6. Deshalb wird Datenbewegung in Phasen zerlegt
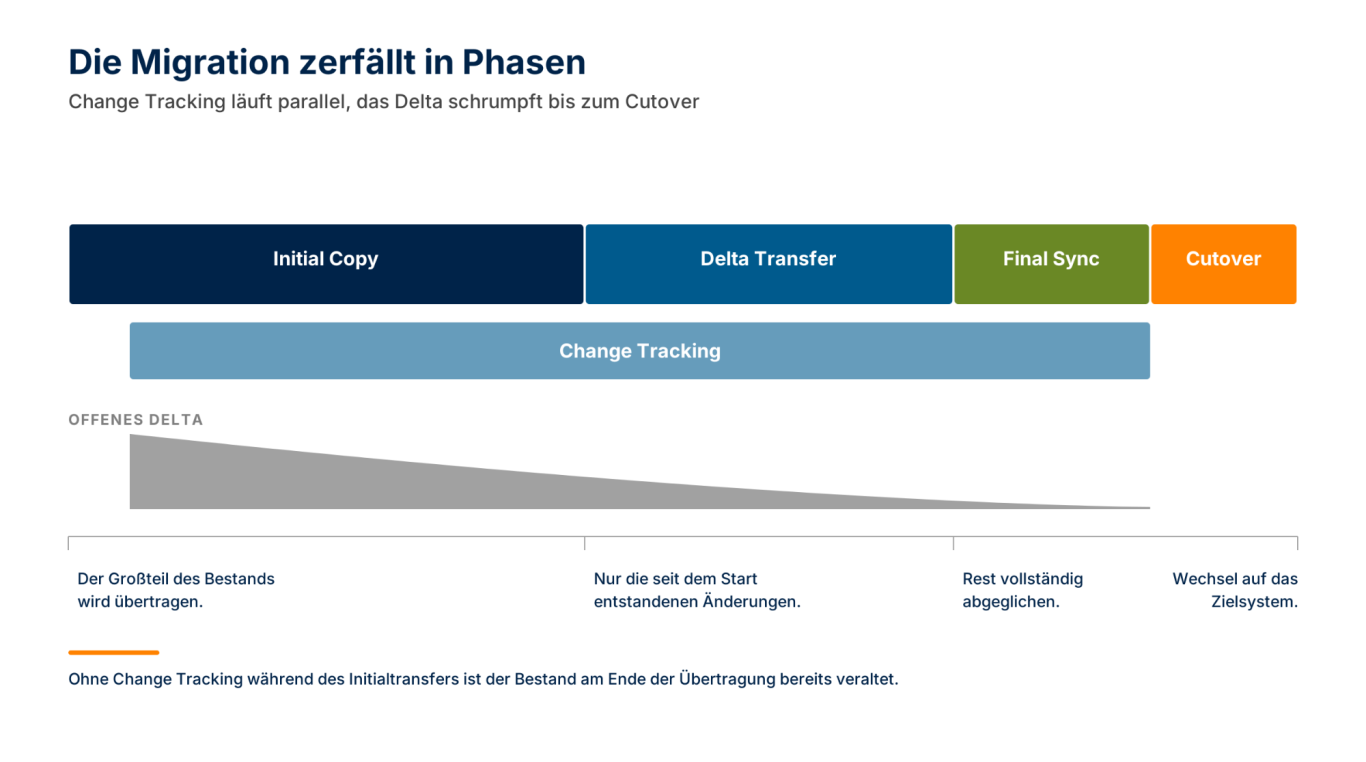
Eine verbreitete Strategie gliedert die Datenbewegung in aufeinanderfolgende Phasen. Zunächst wird der Großteil des vorhandenen Bestands übertragen. Währenddessen werden Änderungen an der Quelle erfasst. Nach dem Initialtransfer folgen nur noch die seitdem entstandenen Änderungen. Kurz vor dem Cutover wird der verbleibende Unterschied minimiert oder vollständig abgeglichen. Erst danach wechseln Anwendungen und Benutzer auf das Zielsystem.
Das zugrunde liegende Prinzip, den vollständigen Datenbestand nicht erneut übertragen zu müssen, lässt sich unterschiedlich umsetzen. Ein bekanntes Beispiel auf Dateiebene ist der rsync-Algorithmus. Er identifiziert Bereiche einer Quelldatei, die auf der Gegenseite bereits vorliegen, und überträgt im Wesentlichen die abweichenden Datenbereiche. Der ursprüngliche technische Bericht von 1996 beschreibt das Verfahren ausdrücklich für Verbindungen mit geringer Bandbreite und hoher Latenz.
Daraus folgt jedoch nicht, dass jedes Cloud-Migrationswerkzeug rsync verwendet. Delta-Verfahren arbeiten auf Datei-, Block-, Objekt-, Journal- oder Applikationsebene und besitzen entsprechend unterschiedliche Eigenschaften.
7. Offline ist nicht automatisch schneller als online
Daten müssen nicht vollständig über eine WAN-Verbindung transportiert werden. Grundsätzlich stehen zwei Modelle zur Wahl.
Online-Transfer nutzt den direkten Datenpfad
Die Daten werden über eine Netzwerkverbindung direkt zum Ziel übertragen. Vorteile sind der direkte Pfad und die Möglichkeit, Erst- und Delta-Läufe ohne physischen Transport durchzuführen. Die praktische Grenze ergibt sich aus dem verfügbaren End-to-End-Durchsatz und dem Transferfenster.
Offline-Transfer verlagert den Engpass in die Logistik
Bei sehr großen Datenbeständen lässt sich ein physisches Transfersystem einsetzen. Die Daten werden lokal auf eine Appliance kopiert, diese wird zum Anbieter transportiert und ihr Inhalt dort in den Cloud-Storage importiert.
Dass dieses Modell nicht nur theoretisch existiert, zeigt die dokumentierte Transfer-Appliance-Architektur von Google Cloud. Sie beschreibt einen Offline- und einen Online-Modus: Im Offline-Modus werden Daten auf die Appliance kopiert, die Appliance anschließend an den Anbieter zurückgesendet und die Daten dort in den Ziel-Bucket übertragen. Im Online-Modus werden die auf die Appliance kopierten Daten stattdessen direkt in den Ziel-Bucket gestreamt. Das Beispiel dient als Nachweis des technischen Verfahrens, nicht als Produktempfehlung.
Offline bedeutet dabei nicht schneller. Der reinen Übertragungszeit über das Netzwerk steht auf dem Offline-Weg die Summe aus lokaler Kopierzeit, Versand und Logistik, Importzeit und gegebenenfalls einem anschließenden Delta-Abgleich gegenüber.
Ein Offline-Seed löst zudem das Problem laufender Änderungen nicht. Verändert sich die Quelle während Transport und Import weiter, bleibt anschließend eine Online-Synchronisation der Deltas erforderlich.
8. Erst die Konsistenzprüfung beendet eine Migration
Eine erfolgreiche Datenübertragung bedeutet noch nicht, dass Quelle und Ziel denselben nutzbaren Zustand besitzen.
Nach einem Transfer sind deshalb Validierungen erforderlich. Geprüft werden je nach Umgebung die Anzahl der Dateien oder Objekte, Größen, Prüfsummen, Metadaten, Zeitstempel, Verzeichnis- oder Namespace-Strukturen, Zugriffsrechte und die Applikationskonsistenz. Welche dieser Eigenschaften zählen, hängt von Quelle, Ziel, Protokoll und Anwendung ab.
Gerade beim Wechsel zwischen unterschiedlichen Storage-Modellen lässt sich nicht voraussetzen, dass jede Eigenschaft der Quelle im Ziel eine direkte Entsprechung besitzt.
Die CDMI-Spezifikation adressiert unter anderem Daten, Container, Metadaten und Data Portability. Die SNIA beschreibt CDMI darüber hinaus als Ansatz zur Datenbewegung zwischen Systemen unter Erhaltung von Struktur, Inhalt und Cross-Protocol-Metadaten. Bei einer konkreten Migration bleibt dennoch zu prüfen, welche Eigenschaften die tatsächlich eingesetzten Quell- und Zielsysteme sowie die verwendeten Transferwerkzeuge unterstützen.
9. Der Transferpfad ist ein zusätzlicher Angriffspfad
Ein Transfer schafft einen zusätzlichen Datenpfad zwischen administrativen Domänen. Authentifizierung, Autorisierung, Verschlüsselung, Zugangsdaten und Protokollierung gehören deshalb zur Planung der Datenbewegung.
NIST SP 800-209 nennt für Storage-Infrastrukturen in der Fassung von 2020 unter anderem Authentication and Authorization, Data Protection, Isolation, Restoration Assurance und Encryption als relevante Sicherheitsbereiche.
Bei einer Migration ist deshalb nicht nur zu prüfen, ob die Daten angekommen sind, sondern auch, wer den Transfer initiieren durfte, welche Identität auf Quelle und Ziel zugreift, wie Daten während der Übertragung geschützt sind, welche Berechtigungen die Transferkomponente besitzt und wie erfolgreiche wie fehlgeschlagene Transfers nachvollziehbar bleiben.
Transferwerkzeuge benötigen häufig weitreichenden Zugriff auf Quelle und Ziel. Wir behandeln diese Berechtigungen deshalb als Bestandteil des Sicherheitsdesigns und nicht als Nebenaspekt der Werkzeugauswahl.
10. Der Rückweg gehört in dieselbe Planung
Eine Cloud-Migration sollte nicht allein als Weg von On-Premises in die Cloud betrachtet werden. Je nach Architektur sind später große Datenmengen in Gegenrichtung zu bewegen, etwa zurück in das eigene Rechenzentrum oder über eine lokale Zwischenstufe zu einem anderen Anbieter.
Technisch zählen dann erneut Bandbreite, Transferdauer, Protokolle, Datenformat und Kompatibilität. Hinzu kommen die Kostenmodelle der eingesetzten Cloud-Dienste.
Gebühren für Datenübertragung, API-Aufrufe oder andere Operationen sind keine allgemeine Eigenschaft der Cloud. Sie sind für den jeweiligen Anbieter, Dienst, die Region und das Vertragsmodell einzeln zu prüfen.
Die technische Exit-Fähigkeit einer Architektur sollte deshalb nicht erst dann untersucht werden, wenn ein Anbieterwechsel bereits beschlossen ist.
11. Welches Verfahren zu welchem Ziel passt
Diese Mechanismen lassen sich kombinieren. Eine Cloud-Migration kann mit einem Initial Seed beginnen, anschließend Änderungen replizieren und beim Cutover einen finalen Delta-Abgleich durchführen.
Ziel
Datenbestand einmalig verlagern
Zweite aktuelle Kopie betreiben
Datenbestände laufend abgleichen
Daten nach Policies verlagern
Wiederherstellbare Kopien erzeugen
Sehr große Erstbefüllung
Typischer Mechanismus
Migration
Replikation
Synchronisation
Tiering
Backup
Online- oder Offline-Seed
Zentrale technische Frage
Wie werden Änderungen während des Transfers nachgeführt?
Welches RPO und welche Konsistenz werden benötigt?
Wie werden Änderungen und Konflikte erkannt?
Wann werden Daten verschoben und wie erfolgt der Recall?
Welche Recovery Points und welches RTO werden benötigt?
Welcher End-to-End-Weg erreicht das erforderliche Transferfenster?
12. Welche Größen vor der Entscheidung bekannt sein müssen
Erst aus der Kombination dieser Größen lässt sich beurteilen, welches Verfahren trägt. Der Datenpfad zwischen Cloud und On-Premises ist damit kein nachgelagertes Migrationsthema, sondern Bestandteil der Architektur.
Parameter
Datenvolumen
Anzahl Dateien und Objekte
Größenverteilung
Änderungsrate
Verfügbare Bandbreite
Gemessener End-to-End-Durchsatz
RTT und Netzwerkqualität
Transferfenster
Quellperformance
Zielperformance und API-Limits
Metadaten und Berechtigungen
Konsistenzanforderungen
Rücktransfer
Bedeutung
Umfang des Initialtransfers
Anzahl zu verarbeitender Einheiten
Verhältnis kleiner zu großen Datenelementen
Nach dem Initialtransfer nachzuführende Datenmenge
Obere Netzwerkgrenze
Realistische Grundlage der Zeitplanung
Einfluss auf Transport- und Protokollverhalten
Verfügbare Zeit für die Übertragung
Erreichbare Leserate
Erreichbare Ingest-Rate
Zusätzlich zu übertragende Semantik
Zulässiger Unterschied zwischen Quelle und Ziel
Technische und wirtschaftliche Exit-Fähigkeit
13. Fazit
Daten zwischen On-Premises und Cloud zu bewegen ist mehr als die Übertragung einer bestimmten Anzahl von Terabytes.
Zuerst ist zu klären, ob eine Migration, eine Replikation, eine Synchronisation, ein Tiering oder ein Backup benötigt wird. Danach bestimmen Datenvolumen, Dateianzahl und Größenverteilung, Änderungsrate, Bandbreite, Latenz, Quell- und Zielperformance sowie Konsistenzanforderungen den geeigneten technischen Ansatz.
Für große statische Datenbestände genügt womöglich ein einmaliger Online- oder Offline-Transfer. Bei produktiv veränderten Beständen wird dagegen häufig ein mehrstufiges Verfahren aus Initialtransfer, Change Tracking, Delta-Transfer, Validierung und Cutover erforderlich.
Die zentrale Planungsgröße ist deshalb nicht, wie viele Daten vorhanden sind, sondern wie schnell sich ein konsistenter Datenbestand überführen lässt, während die Quelle sich weiter verändert, und ob derselbe Datenpfad im Bedarfsfall auch in Gegenrichtung trägt.
14. Quellen
ISO/IEC: ISO/IEC 17826:2022 — Information technology — Cloud Data Management Interface (CDMI) Version 2.0.0, Edition 3, Mai 2022. ISO/IEC 17826:2022 (abgerufen am 07.09.2026)
Storage Networking Industry Association (SNIA): Cloud Data Management Interface (CDMI), Informationen zum Standard und zu Data Portability. SNIA — Cloud Data Management Interface (abgerufen am 07.09.2026)
SNIA: Data Replication, Synchronous Replication, Asynchronous Replication, Continuous Data Protection, Automated Storage Tiering und Tiered Storage, SNIA Dictionary. SNIA Dictionary (abgerufen am 07.09.2026)
Ramaswamy Chandramouli, Doron Pinhas / National Institute of Standards and Technology: Security Guidelines for Storage Infrastructure, NIST Special Publication 800-209, Oktober 2020, DOI 10.6028/NIST.SP.800-209. Finale Fassung; auf diese Fassung wird im Artikel ausdrücklich Bezug genommen. NIST SP 800-209 (abgerufen am 07.09.2026)
Ramaswamy Chandramouli / National Institute of Standards and Technology: Security Guidelines for Storage Infrastructure, NIST SP 800-209 Rev. 1, Initial Public Draft, 22. Juli 2026, DOI 10.6028/NIST.SP.800-209r1.ipd. Entwurfsstatus; Kommentierungsfrist bis 08.09.2026. NIST SP 800-209 Rev. 1 ipd (abgerufen am 07.09.2026)
Andrew Tridgell, Paul Mackerras / Australian National University: The rsync algorithm, Technical Report TR-CS-96-05, Department of Computer Science, Canberra, Juni 1996. The rsync algorithm (abgerufen am 07.09.2026)
B. Constantine, G. Forget, R. Geib, R. Schrage / IETF: RFC 6349 — Framework for TCP Throughput Testing, August 2011. RFC 6349 (abgerufen am 07.09.2026)
S. Floyd (Ed.) / IETF: RFC 5166 — Metrics for the Evaluation of Congestion Control Mechanisms, März 2008. RFC 5166(abgerufen am 07.09.2026)
Google Cloud: Transfer Appliance — High-level overview, Produktdokumentation Version 4.0; als Implementierungsbeispiel für physische und netzbasierte Datentransfers. Transfer Appliance — Overview (abgerufen am 07.09.2026)
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur