WISSEN > KI ARCHITEKTUR > STORAGE WORKLOADS DATENPFAD
Warum Training, RAG und Checkpointing unterschiedliche Storage-Workloads erzeugen
Autor: Dirk Neumann Geschäftsführer ASSISTRA Cloud Services GmbH 17.08.2026
Storage für KI beginnt beim Workload, nicht beim Speichermedium
Das sollten Sie mitnehmen:
- KI benötigt nicht „den“ AI Storage.
Training, RAG, Inference, Datenaufbereitung und Checkpointing erzeugen jeweils eigene Storage-Workloads.
- Durchsatz, IOPS und Latenz sind unterschiedliche Größen.
Welche davon entscheidend ist, hängt allein vom Zugriffsmuster ab, nicht von der gespeicherten Datenmenge.
- Object Storage liefert hohe aggregierte Datenraten über Parallelität.
Objektgröße, Netzwerk und Skalierung des Storage-Systems bestimmen, ob dieser Durchsatz tatsächlich entsteht.
- File Storage bleibt für KI relevant.
Vorhandene Unternehmensdaten, Anwendungen und Frameworks können File-Semantik oder POSIX-nahe Zugriffsmodelle voraussetzen, die ein Objekt nicht ersetzt.
- Der Datenpfad endet nicht am Storage-System.
Netzwerk, Host Memory, CPU, PCIe und GPU-Anbindung entscheiden mit darüber, ob Storage-Leistung beim Compute ankommt.

Inhaltsverzeichnis
- KI ist kein einzelner Storage-Workload, sondern eine Kette unterschiedlicher I/O-Profile
- Durchsatz, IOPS und Latenz beschreiben unterschiedliche Engpässe
- Object Storage erreicht Durchsatz über Parallelität, nicht über den einzelnen Zugriff
- File Storage bleibt relevant, weil Anwendungen Semantik erwarten
- Der Datenpfad endet nicht am Storage-System
- Nicht alle KI-Daten gehören auf Flash
- Training und Checkpointing belasten entgegengesetzte Pfade
- RAG erzeugt einen dritten Workload-Typ
- Eine belastbare Architektur beginnt bei der Charakterisierung der Daten
- Fazit
- Quellen
KI-Anwendungen stellen nicht eine einzige neue Anforderung an Storage. Entscheidend ist, in welcher Phase eines KI-Workflows Daten gespeichert, gelesen oder geschrieben werden und welches Zugriffsmuster dabei entsteht. Ein Repository mit Trainingsdaten stellt andere Anforderungen als ein GPU-Cluster während des Trainings, eine RAG-Pipeline greift anders auf Daten zu als ein Training-Job, und die langfristige Ablage von Modellen oder Checkpoints benötigt nicht dieselbe Latenz wie ein Storage-System im aktiven Datenpfad einer Inferenzanwendung.
Deshalb lässt sich die Frage, welchen Storage KI benötigt, nicht pauschal mit File Storage, Object Storage oder All-Flash beantworten. Maßgeblich sind stattdessen mehrere Größen, die getrennt betrachtet werden müssen: der Durchsatz als pro Zeiteinheit übertragene Datenmenge, die Latenz einer einzelnen I/O-Operation, die Anzahl der zu verarbeitenden Einzelzugriffe, die Parallelität gleichzeitig zugreifender Clients, Prozesse oder GPUs sowie die Verteilung der Datei- und Objektgrößen. Hinzu kommen zwei Fragen, die häufig übersehen werden: welche Komponenten die Daten auf ihrem Weg vom Speichermedium bis zur Anwendung oder GPU passieren müssen und welche Zugriffsschnittstelle die Anwendung tatsächlich erwartet — File-Semantik oder beispielsweise eine S3-kompatible Object API. Eine Storage-Architektur für KI ist deshalb vom Datenpfad und vom Workload her zu planen, nicht von Kapazität oder Speichermedium her.
1. KI ist kein einzelner Storage-Workload, sondern eine Kette unterschiedlicher I/O-Profile
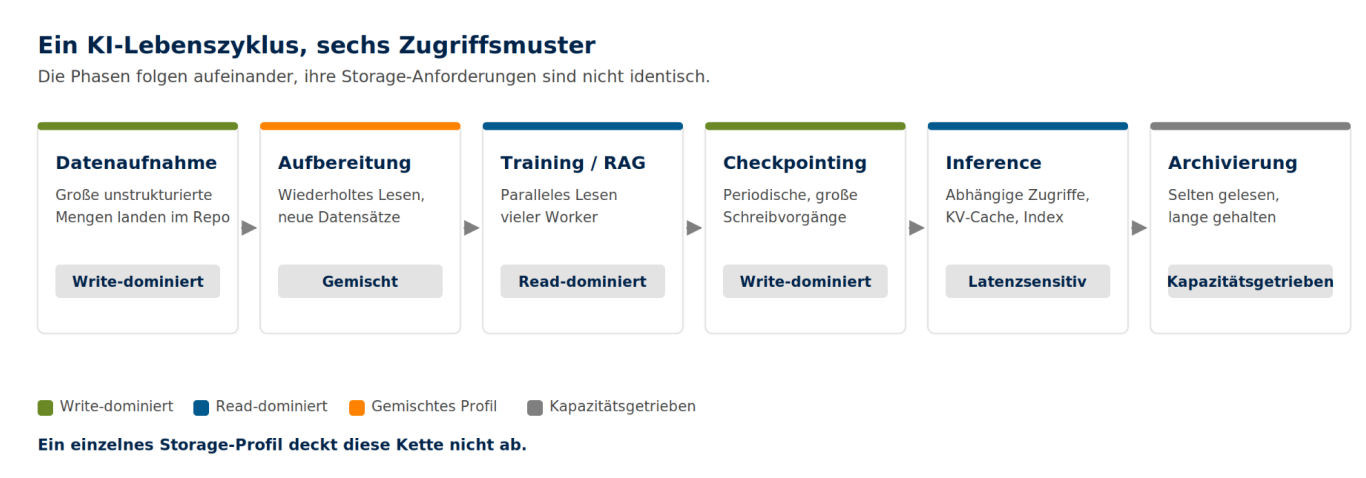
Unter dem Begriff KI werden technisch sehr unterschiedliche Prozesse zusammengefasst. Bereits innerhalb eines typischen AI-Lifecycles treten mehrere I/O-Muster auf: Datenaufnahme, Aufbereitung, Training oder RAG, Checkpoint- und Modellablage, Inference sowie Archivierung beziehungsweise Wiederverwendung. Bei der Datenaufnahme werden große Mengen unstrukturierter Daten zunächst dauerhaft gespeichert, die Aufbereitung liest diese Daten wiederholt und erzeugt neue Datensätze, Training liest große Datenmengen parallel und schreibt periodisch umfangreiche Checkpoints, und Retrieval-Augmented Generation benötigt Zugriff auf Quelldokumente, Chunks, Metadaten, Embeddings und Indizes. Die daraus entstehenden Storage-Anforderungen sind nicht identisch.
Dass es sich um verschiedene Workloads und nicht um Abstufungen desselben Workloads handelt, lässt sich inzwischen auch außerhalb von Herstellerdarstellungen belegen. MLCommons hat die MLPerf-Storage-Suite, die Storage-Systeme für ML-Workloads architekturneutral, repräsentativ und reproduzierbar vermisst, schrittweise um genau diese Profile erweitert. Version 2.0 ergänzte 2025 Tests, die reales Checkpointing in KI-Trainingssystemen nachbilden; Version 3.0 kam am 1. September 2026 mit einem KV-Cache-Test für Lese- und Schreiboperationen des Inference-Caches sowie einem Vector-Database-Test für Indexierungs- und Query-Workloads hinzu. Ein Benchmark, der ursprünglich nur Trainingsdurchsatz maß, bildet damit heute vier unterscheidbare Zugriffsprofile ab.
Herstellerseitig wird dieselbe Aufteilung vorgenommen. Scality unterscheidet in der Beschreibung seiner AI-Datenpfad-Architektur AIConnect vier Lastprofile und ordnet ihnen unterschiedliche Anforderungen zu: Training zieht anhaltenden sequenziellen Durchsatz, Inference verlangt Reads im Submillisekundenbereich gegen KV-Caches, Retrieval erzeugt metadatenlastige nebenläufige Reads gegen sehr große Objektbestände, und agentische Workloads erzeugen gemischte und stoßweise Last. Das ist eine Herstellerbeschreibung und keine allgemeingültige Spezifikation, deckt sich in der Grundaussage aber mit der Entwicklung des neutralen Benchmarks.
Damit lautet die erste Frage bei der Storage-Planung nicht, wie schnell der AI Storage sein muss, sondern welche Daten von welcher Komponente in welcher Form und mit welchem Zugriffsmuster benötigt werden. Einordnung der Storage-Ebene in die Gesamtarchitektur
2. Durchsatz, IOPS und Latenz beschreiben unterschiedliche Engpässe
Eine der wichtigsten Voraussetzungen für das Sizing einer KI-Storage-Architektur ist die saubere Trennung dieser Performancegrößen, die in Ausschreibungen und Herstellerangaben regelmäßig vermischt werden.
Throughput beschreibt die pro Zeiteinheit übertragene Datenmenge, beispielsweise in GB/s. Hoher Durchsatz wird relevant, wenn große Datenmengen innerhalb begrenzter Zeit verarbeitet werden müssen, etwa beim Training mit großen Datensätzen oder beim Verschieben großer Datenbestände zwischen Storage- und Compute-Infrastruktur. Ein Storage-System kann dabei einen hohen aggregierten Durchsatz liefern, obwohl die Latenz einer einzelnen Operation vergleichsweise hoch ausfällt.
IOPS beschreibt bei Block- und File-Storage die Anzahl der I/O-Operationen pro Sekunde; bei Object Storage wird entsprechend die Request Rate betrachtet. Die Größe einer einzelnen Operation ist dabei entscheidend, denn 100.000 Operationen mit jeweils 4 KiB und 100.000 Operationen mit jeweils 1 MiB stellen völlig unterschiedliche Anforderungen an Storage und Netzwerk.
Latency beschreibt die Zeit zwischen einer Anfrage und ihrer Verarbeitung beziehungsweise Antwort. Sie wird insbesondere dann relevant, wenn eine Anwendung viele voneinander abhängige Zugriffe ausführt und ein nachfolgender Schritt erst beginnen kann, nachdem der vorherige abgeschlossen wurde. Ein hoher Gesamtdurchsatz kompensiert eine für den jeweiligen Workload zu hohe Einzelzugriffslatenz deshalb nicht automatisch.
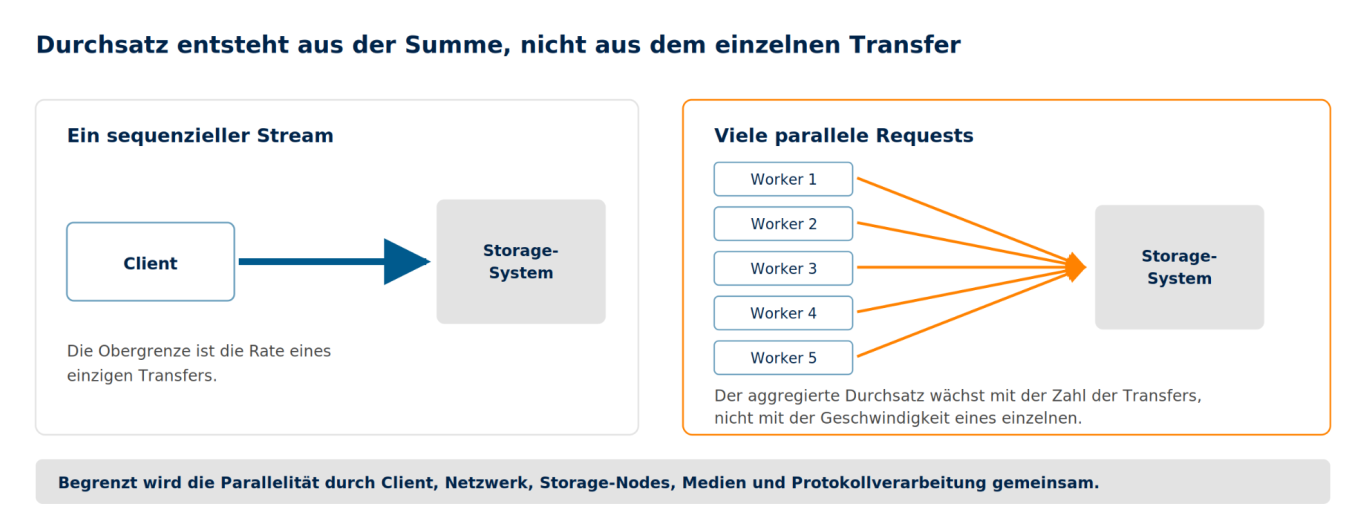
Hinzu kommt die Parallelität, mit der sich das Storage-Verhalten am deutlichsten verändert. Statt eines einzelnen Clients fordern zahlreiche Worker oder Compute Nodes gleichzeitig Daten an, und die Fähigkeit eines Storage-Systems, solche parallelen Zugriffe zu verteilen, kann wichtiger sein als die maximale Geschwindigkeit eines einzelnen I/O-Streams. Diese Eigenschaft ist insbesondere für verteilten Object Storage relevant.
Wer aus diesen Größen eine Einkaufsanforderung ableiten will, sollte beachten, dass veröffentlichte Benchmarkzahlen nur innerhalb ihres jeweiligen Rahmens vergleichbar sind. MLCommons weist für MLPerf Storage ausdrücklich aus, dass Ergebnisse innerhalb eines Workloads vergleichbar sind, nicht aber über Workloads hinweg, und dass Vergleiche über Modelle oder Accelerator-Typen hinweg nicht aussagekräftig sind. In Version 3.0 werden NVIDIA B200 und AMD MI355X als Accelerators emuliert, wobei jeder Typ eigene Batchgrößen und Rechenzeiten mitbringt und damit faktisch einen eigenen Workload definiert. Die Lesebandbreite je simuliertem Accelerator ist zudem durch die Benchmarkdefinition annähernd festgelegt, sodass Unterschiede zwischen Einreichungen an dieser Stelle Rauschen sind und kein Leistungsmerkmal. Eine isolierte Durchsatz- oder IOPS-Zahl ohne Angabe von Workload, Zugriffsmuster und Accelerator-Typ trägt deshalb keine Architekturentscheidung.
3. Object Storage erreicht Durchsatz über Parallelität, nicht über den einzelnen Zugriff
Object Storage besitzt Eigenschaften, die für große KI-Datenbestände interessant sind: einen flachen beziehungsweise bucket-basierten Namensraum, API-basierten Zugriff, Metadaten am Objekt und Architekturen, die auf horizontale Skalierung großer Datenmengen ausgelegt sein können. Insbesondere unstrukturierte Daten wie Bilder, Videos, Dokumente, Log- oder Sensordaten lassen sich als Objekte ablegen. Die entscheidende Einschränkung lautet dennoch, dass Object Storage nicht automatisch schneller oder langsamer ist als File Storage, denn die erreichbare Performance hängt von der konkreten Implementierung und vom Workload ab.
Amazon empfiehlt für High-Performance-Anwendungen auf S3 ausdrücklich, mehrere gleichzeitige Requests über getrennte Verbindungen zu verteilen, und rät dazu, S3 beim Bau leistungsfähiger Anwendungen als sehr großes verteiltes System und nicht als einzelnen Netzwerk-Endpunkt im Sinne eines klassischen Storage-Servers zu betrachten. Auch unterschiedliche Byte Ranges desselben Objekts lassen sich über nebenläufige Verbindungen abrufen, was gegenüber einem einzelnen Request auf das gesamte Objekt einen höheren aggregierten Durchsatz ermöglicht. Der Durchsatz entsteht in diesem Modell also nicht aus der Geschwindigkeit eines einzelnen Transfers, sondern aus der Summe vieler gleichzeitiger Transfers.
Das bedeutet allerdings nicht, dass beliebig viele parallele Requests automatisch höhere Performance erzeugen. Client, Netzwerk, Storage-Nodes, Medien, Protokollverarbeitung und die konkrete Implementierung bilden gemeinsam den Datenpfad und begrenzen ihn jeweils an ihrer eigenen Stelle.
Dass Object Storage inzwischen auch für trainings- und inferencenahe Zugriffe ernsthaft betrachtet wird, zeigt sich am Benchmark selbst: MLPerf Storage v3.0 ergänzt die bestehende POSIX-Zugriffsschicht erstmals um eine S3-Objektzugriffsschicht. Damit werden Object- und File-Zugriff im selben Testrahmen messbar, statt nur gegeneinander behauptet zu werden.
Objektgröße und Objektanzahl gehören in jedes Sizing
Die reine Datenmenge reicht nicht aus, um einen Storage-Workload zu charakterisieren. Ein Dataset von 100 TB kann aus vergleichsweise wenigen großen Objekten oder aus sehr vielen kleinen Dateien beziehungsweise Objekten bestehen, und beide Fälle belasten dieselbe Infrastruktur völlig unterschiedlich.
Bei großen Objekten macht der Datentransfer einen großen Anteil der Gesamtoperation aus. Bei kleinen Objekten steigt dagegen relativ zur Nutzdatenmenge die Bedeutung der Verarbeitung einzelner Requests und, bei File-Systemen, von Namespace- und Metadatenoperationen. AWS empfiehlt für den parallelen Abruf großer Objekte deshalb Byte Ranges in einer Größenordnung von acht bis sechzehn Megabyte und, sofern Objekte per Multipart Upload geschrieben wurden, den Abruf in denselben Part-Größen oder zumindest an Part-Grenzen ausgerichtet.
Wie stark das wiegt, zeigt der Vergleich zweier Trainings-Workloads desselben Benchmarks. 3D U-Net liest Dateien von im Mittel rund 140 MiB vollständig und sequenziell, wofür ein simulierter B200-Accelerator etwa 5,9 GiB/s Lesebandbreite verlangt. RetinaNet liest Dateien von rund 315 KiB in zufälliger Reihenfolge; dort benötigt derselbe simulierte Accelerator nur etwa 155 MiB/s, öffnet und liest dafür aber rund 500 Dateien pro Sekunde, sodass bei hohen Accelerator-Zahlen Hunderttausende Dateizugriffe pro Sekunde aus einem Namensraum von Millionen Dateien zu bedienen sind. MLCommons beziffert den Bandbreitenbedarf eines U-Net-Accelerators auf etwa das Achtunddreißigfache eines RetinaNet-Accelerators. Der Unterschied entsteht allein aus der Dateigröße, bei identischem Accelerator-Typ.
Wir haben in Sizing- und Migrationsprojekten wiederholt beobachtet, dass genau diese Angaben fehlen, wenn eine Anforderung an uns herangetragen wird. Eine Kapazitätsangabe wie „500 TB Trainingsdaten" beschreibt den Bestand, aber nicht den Workload; erst Anzahl der Objekte, Größenverteilung, Zugriffsmuster und Parallelität machen daraus eine planbare Anforderung.
4. File Storage bleibt relevant, weil Anwendungen Semantik erwarten
Dass Object Storage für große AI-Datasets geeignet sein kann, macht File Storage nicht überflüssig. Ein großer Teil vorhandener Unternehmensdaten liegt bereits in File-Systemen, und Anwendungen erwarten häufig eine File-Schnittstelle mit Pfaden, Verzeichnissen und klassischen File-Operationen. Ein AI-Datenpfad kann deshalb über NFS oder ein anderes File-System auf den Storage zugreifen, während eine andere Anwendung derselben Umgebung direkt eine S3-API verwendet.
Die Wahl sollte sich nicht daran orientieren, welche Storage-Technologie als „AI Storage" bezeichnet wird, sondern daran, welche Schnittstelle die Anwendung tatsächlich benötigt. Hinzu kommt, dass File Storage und Object Storage unterschiedliche Semantiken besitzen. Ein S3-Objekt ist nicht einfach eine Datei mit einem anderen Zugriffsprotokoll, sondern unterscheidet sich in Konsistenzverhalten, Änderungsoperationen, Namensraumstruktur und Metadatenmodell.
Gerade bei vorhandenen Unternehmensdaten ist diese Unterscheidung wichtig. Werden Daten ausschließlich für eine KI-Anwendung in ein neues Repository kopiert, entsteht zusätzlich zur Storage-Frage eine Frage der Datenhaltung: Welche Kopie ist maßgeblich, wie werden Änderungen übernommen, und wie wird verhindert, dass KI auf veralteten Daten arbeitet?
In Unternehmensumgebungen ist nicht zwangsläufig zwischen File oder Object zu entscheiden. Beide können unterschiedliche Aufgaben innerhalb derselben Infrastruktur erfüllen, und zwischen dauerhaftem Bestand und Compute kommen weitere Klassen hinzu. Die folgende Übersicht ist keine Produktzuordnung, sondern zeigt, dass eine AI-Infrastruktur mehrere Storage-Klassen kombinieren kann, ohne dass daraus ein Widerspruch entsteht.
File Storage
Trägt vorhandene Unternehmensdateien und alle Anwendungen, die File-Semantik mit Pfaden, Verzeichnissen und klassischen File-Operationen erwarten.
Object Storage
Nimmt große unstrukturierte Datenbestände auf und bedient Anwendungen, die ohnehin S3-nativ über eine Object API zugreifen.
Skalierbarer Capacity Storage
Hält große, langlebige Datensätze wirtschaftlich über lange Zeiträume, ohne Performanceanforderungen des aktiven Datenpfads erfüllen zu müssen.
Performance Tier
oder Cache
Stellt die Daten bereit, die im laufenden Betrieb wiederholt gebraucht werden, und überbrückt die Distanz zwischen Capacity Layer und Compute.
Lokaler NVMe-Speicher und Scratch
Nimmt temporäre Daten eines einzelnen Verarbeitungsschrittes auf und vermeidet wiederholtes Lesen derselben Daten über das Storage-Netz.
Modell- und Checkpoint-Ablage
Lässt sich keiner Klasse fest zuordnen. Ob Flash oder Capacity Layer richtig ist, hängt von der Anwendung und vom Zugriffspfad ab.
5. Der Datenpfad endet nicht am Storage-System
Die Performancebetrachtung darf nicht am Storage-System enden. Ein vereinfachter klassischer Datenpfad umfasst mehrere Komponenten: Die Daten werden vom Speichermedium gelesen, über Netzwerk und NIC transportiert, im Host verarbeitet, in den System Memory geschrieben und erst von dort an die GPU übergeben. Zu Begrenzungen des Gesamtdurchsatzes können damit das Storage-System selbst, das Storage-Protokoll, das Netzwerk, die NIC, PCIe, die CPU, der Host Memory, der Software-Stack und die GPU-Anbindung beitragen. Ein schnelleres Storage-System verbessert den Gesamtprozess nur dann, wenn der restliche Datenpfad die zusätzliche Datenrate auch verarbeiten kann.
Dass diese Betrachtung nicht theoretisch ist, zeigt die Konstruktion des MLPerf-Storage-Trainingstests. Gemessen wird dort nicht die maximale Datenrate im luftleeren Raum, sondern wie viele simulierte Accelerators ein Storage-System gleichzeitig beschäftigt halten kann. Gültig ist ein Lauf nur, wenn die Accelerator-Auslastung eine je Workload festgelegte Schwelle hält: 90 Prozent bei 3D U-Net, 85 Prozent bei RetinaNet. Die Zielgröße ist damit die Auslastung des Compute und nicht die Kennzahl des Storage.
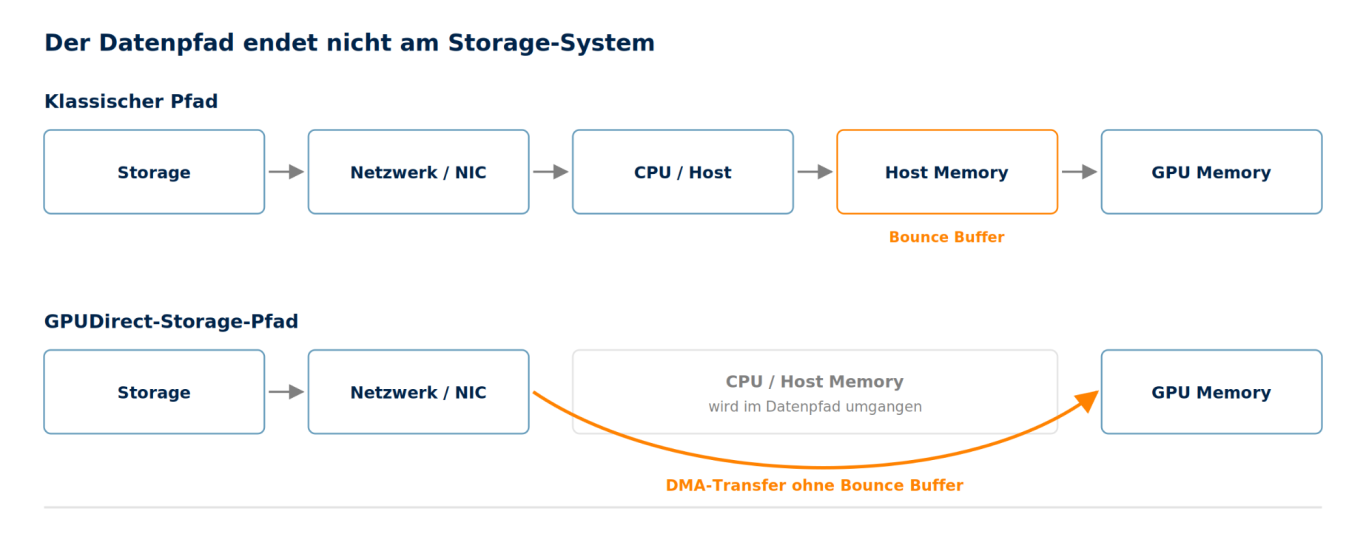
GPUDirect Storage zeigt, was ein verkürzter Datenpfad bewirkt
NVIDIA GPUDirect Storage macht dieses Prinzip explizit. NVIDIA beschreibt GDS als direkten Datenpfad zwischen lokalem oder entferntem Storage — genannt werden NFS-Server sowie NVMe und NVMe over Fabrics — und dem GPU Memory. GDS führt dabei DMA-Transfers zwischen GPU Memory und Storage aus und vermeidet so den sonst notwendigen Umweg über einen Bounce Buffer im Host Memory der CPU. Als Auswirkungen dieses direkten Pfads nennt NVIDIA eine höhere Systembandbreite sowie eine geringere Latenz und eine reduzierte CPU-Last.
Die tatsächlichen Auswirkungen hängen jedoch von Hardware, Filesystem, Treibern und der unterstützten Konfiguration ab, und diese Abhängigkeit ist konkret dokumentiert. NVIDIA weist für den vGPU-Betrieb unter AI Enterprise aus, dass GPUDirect Storage auf GPUs der Ampere-Architektur nicht unterstützt wird, bei Ada Lovelace, Hopper und Blackwell den auf den offenen NVIDIA-Linux-Kernelmodulen basierenden Gasttreiber voraussetzt und ausschließlich unter Linux zur Verfügung steht. Wer GDS in eine Architektur einplant, plant damit implizit auch GPU-Generation, Treiberstand und Betriebssystem mit ein.
Das Beispiel zeigt ein grundsätzliches Architekturprinzip: Die Performance eines KI-Storage-Systems ergibt sich nicht allein aus der Geschwindigkeit der Storage-Medien, sondern aus dem vollständigen Datenpfad zwischen persistentem Storage und Compute.
Das Netzwerk ist Teil der Storage-Architektur
Bei zentralem oder disaggregiertem Storage muss jede benötigte Datenmenge letztlich über ein Netzwerk zum Compute gelangen. Für den Datenpfad gilt deshalb vereinfacht, dass der nutzbare Durchsatz die langsamste relevante Komponente nicht überschreiten kann. Ein Storage-System, das theoretisch 100 GB/s liefern könnte, kann diese Datenrate einem Compute-Cluster nicht bereitstellen, wenn der tatsächlich nutzbare Netzwerkpfad wesentlich weniger transportiert. Umgekehrt garantiert ein schnelles Netzwerk nicht, dass Storage oder Clients genügend parallele I/O-Operationen erzeugen, um es auszulasten.
Bei einem AI-Storage-Sizing gehören deshalb Storage, Frontend und Protokoll, Netzwerk, Compute Node sowie Memory- und GPU-Anbindung zusammen betrachtet, nicht Storage und Speichermedium allein.
6. Nicht alle KI-Daten gehören auf Flash
Aus der Verwendung von GPUs oder anderen Accelerators folgt nicht, dass sämtliche KI-Daten auf Flash gespeichert werden müssen. Entscheidend ist, welche Daten zu welchem Zeitpunkt mit welcher Geschwindigkeit benötigt werden. Daten, die gerade aktiv verarbeitet werden, besitzen andere Performanceanforderungen als Rohdaten, historische Trainingsdaten, ältere Checkpoints, Modellversionen, Ergebnisse vergangener Runs, compliance-relevante Bestände oder Daten, die nur für zukünftige Trainingsläufe vorgehalten werden.
Daraus entsteht eine mehrstufige Architektur, in der ein Capacity Storage den dauerhaften Bestand hält, ein Performance Tier oder Cache die aktiv benötigten Daten bereitstellt und das Compute darauf zugreift. Statt den gesamten Datenbestand permanent auf dem teuersten Tier vorzuhalten, werden Daten entsprechend ihres Zugriffsprofils zwischen den Storage-Klassen bereitgestellt. Ob dieses Modell trägt, hängt davon ab, wie schnell Daten zwischen den Ebenen bewegt werden können und wie vorhersehbar die Zugriffe sind. Tiering und Staging beseitigen Datenbewegung nicht, sie machen sie zu einem expliziten Bestandteil der Architektur.
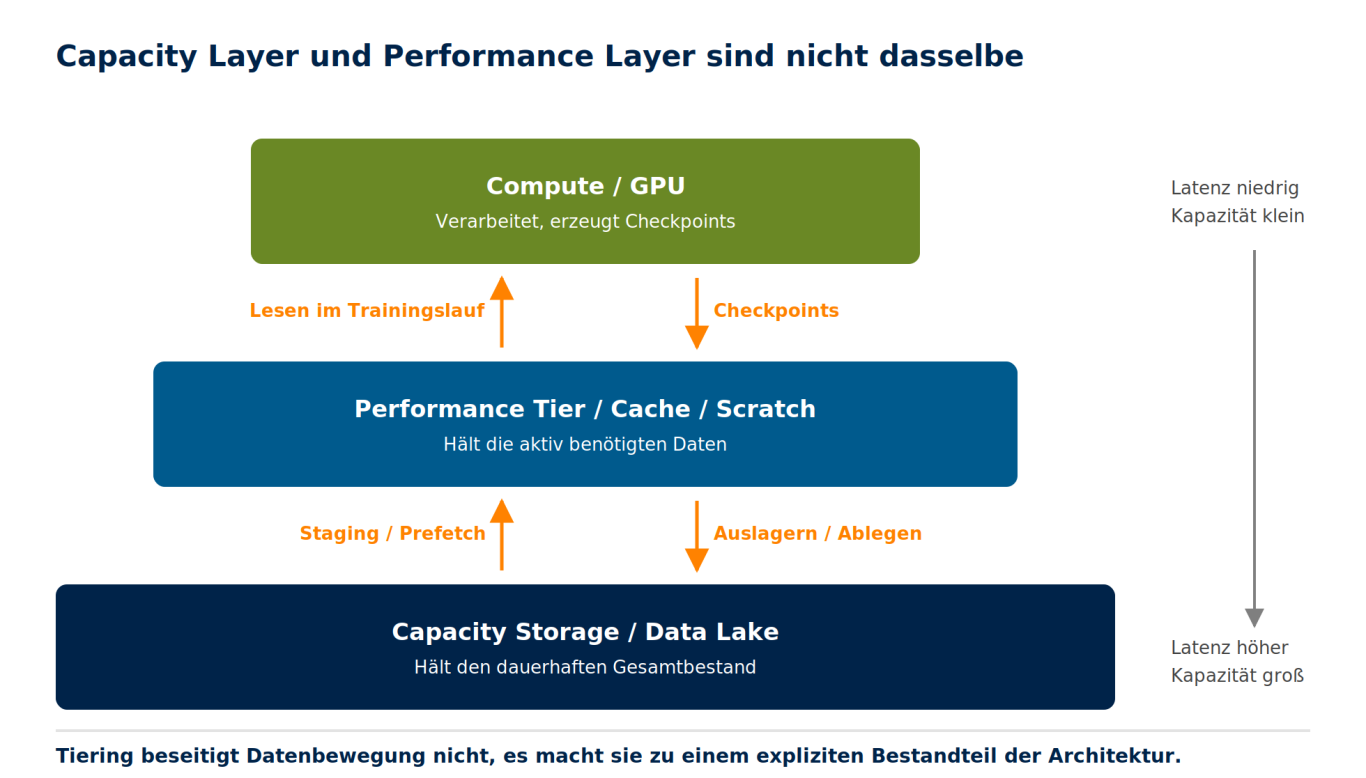
Dass Capacity Layer und Performance Layer nicht identisch sein müssen, formulieren auch Anbieter, die ausschließlich die Capacity-Ebene liefern. Wasabi positioniert Object Storage für KI als S3-kompatiblen Layer über den gesamten Datenlebenszyklus, von Ingest und Trainingsdaten über Checkpoints und Modellartefakte bis zur Langzeitaufbewahrung, und beschreibt diesen Layer ausdrücklich als Ergänzung zu dem beim Kunden bereits vorhandenen schnellen Tier. Ein anderer Workload kann dagegen ohne zusätzliches Staging direkt auf einen ausreichend leistungsfähigen skalierbaren Object Store zugreifen. Welche Variante geeignet ist, lässt sich nur anhand des tatsächlichen Workloads entscheiden.
Lokaler NVMe-Speicher verlagert das Problem, er löst es nicht
Lokale NVMe-Medien können eine weitere Rolle übernehmen. Ein Compute Node übernimmt Daten aus einem zentralen Repository und speichert sie während eines Verarbeitungsschrittes lokal zwischen, wodurch wiederholtes Lesen derselben Daten über das Storage-Netz entfällt.
Dieser Ansatz besitzt einen offensichtlichen Trade-off, denn die lokale Kopie verbraucht zusätzliche Kapazität und muss zunächst erzeugt beziehungsweise aktualisiert werden. Bei sehr großen Datensätzen kann gerade das Staging selbst zum Problem werden. Wir sehen in Projekten regelmäßig, dass diese Transferzeit in der Planung fehlt: Wenn ein Training erst beginnen kann, nachdem viele Terabyte vom zentralen Repository auf lokale Medien übertragen wurden, gehört diese Zeit in die Gesamtbetrachtung des Trainingslaufs und nicht in eine Fußnote der Infrastrukturbeschreibung.
7. Training und Checkpointing belasten entgegengesetzte Pfade
Auch innerhalb eines einzelnen Trainingsprozesses treten unterschiedliche Storage-Workloads auf. Beim Lesen eines Trainingsdatensatzes dominiert je nach Dataset und Software ein Read-Workload. Checkpointing kehrt die Richtung um: Der Zustand eines laufenden Trainings wird vom Compute zurück in den Storage geschrieben, periodisch und persistent. Die benötigte Write Performance hängt von Größe und Häufigkeit der Checkpoints sowie von der Anzahl gleichzeitig schreibender Prozesse ab. Eine Architektur kann damit sehr hohe Read Performance besitzen und trotzdem beim Checkpointing zum Engpass werden, weshalb Read- und Write-Pfade getrennt zu betrachten sind.
Diese Trennung ist inzwischen Bestandteil der neutralen Messmethodik. MLCommons hat mit MLPerf Storage v2.0 Checkpointing als eigenständigen Workload aufgenommen und begründet dies damit, dass die synchrone Natur des KI-Trainings die Ausfallwahrscheinlichkeit eines Clusters mit der Zahl seiner Komponenten wachsen lässt und regelmäßige Checkpoints deshalb als notwendig gelten, um große Trainingsläufe überhaupt performant zu halten. Jede Sekunde, die ein Checkpoint zum Schreiben benötigt, ist Leerlaufzeit der Accelerators.
Auch Scality führt Training, Fine-Tuning und Checkpointing als zusammengehörige Phase, in der der Storage-Layer entweder mithält oder das GPU-Budget verbrennt. Das ist eine produktspezifische Herstellerposition, illustriert aber dieselbe Trennung.
8. RAG erzeugt einen dritten Workload-Typ
Bei Retrieval-Augmented Generation wird Storage nicht für einen großen Trainingslauf benötigt, sondern für eine Kette aus mehreren Datenbeständen. In der Aufbereitung werden Quelldaten extrahiert, in Chunks zerlegt, in Embeddings überführt und indiziert. Bei einer Anfrage folgt darauf ein Retrieval, das relevante Chunks ermittelt und als Kontext an das Sprachmodell übergibt.
Damit existieren mehrere unterschiedliche Bestände nebeneinander: Originaldokumente, extrahierte Inhalte, Chunks, Metadaten, Embeddings, ein Vector Index und gegebenenfalls Cache-Daten. Diese Komponenten müssen nicht auf demselben Storage-System liegen. Der persistente Dokumentbestand kann auf File oder Object Storage liegen, während spezialisierte Datenbanken beziehungsweise Indexsysteme Embeddings und Retrieval-Strukturen verwalten.
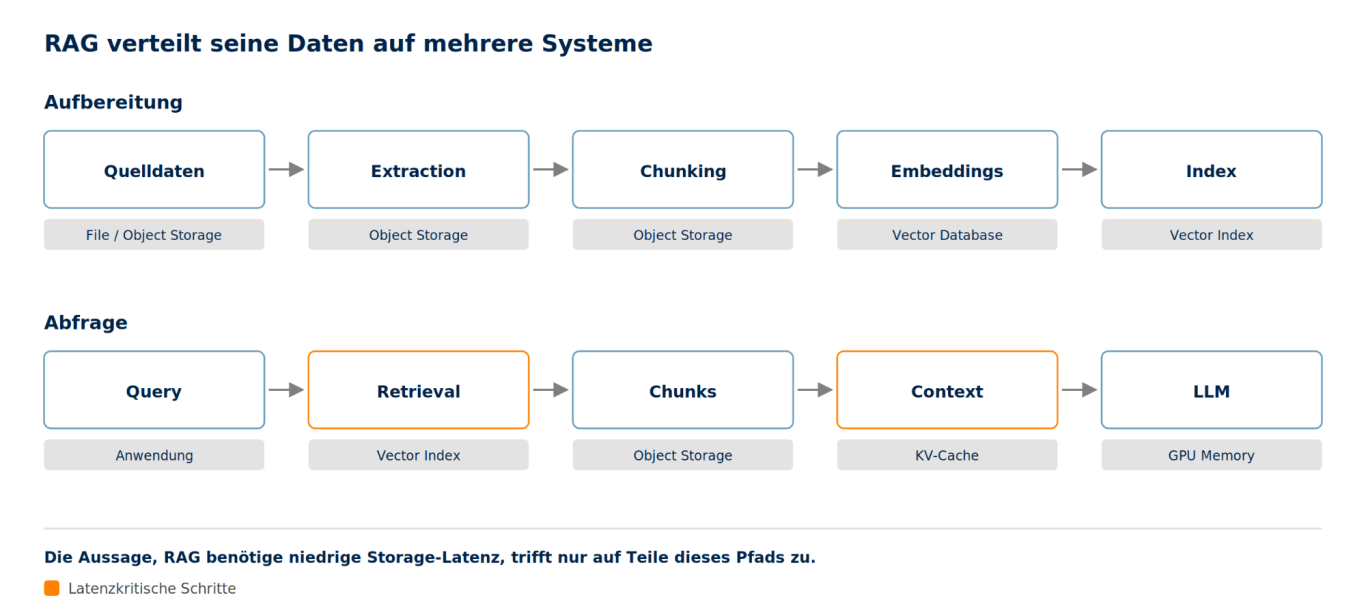
Damit wird auch deutlich, warum die Aussage, RAG benötige niedrige Storage-Latenz, zu pauschal wäre. Entscheidend ist, welcher Teil des Retrieval-Pfads betrachtet wird und welches System die jeweilige Operation ausführt. Dass Vector-Datenbank- und KV-Cache-Zugriffe in MLPerf Storage v3.0 als jeweils eigene Tests neben Training und Checkpointing geführt werden, unterstreicht, dass es sich nicht um Varianten eines einzelnen Profils handelt.
9. Eine belastbare Architektur beginnt bei der Charakterisierung der Daten
Vor einer Produkt- oder Technologieentscheidung sind zunächst die Daten zu beschreiben. Wir arbeiten dafür mit einem überschaubaren Fragenkatalog, der allerdings vollständig beantwortet sein muss, weil jede offene Position später als Annahme in die Auslegung eingeht.
Zunächst ist zu klären, welche Daten überhaupt existieren. Dokumente, Bilder, Video, Audio, Datenbankexporte, Logs, Sensordaten, Trainingsdatasets sowie Modelle und Checkpoints unterscheiden sich in Größe, Struktur und Lebensdauer erheblich. Anschließend ist der Bestand zu quantifizieren, und zwar nicht nur in Terabyte oder Petabyte, sondern zusätzlich nach Anzahl der Dateien beziehungsweise Objekte, durchschnittlicher Größe, Größenverteilung und Wachstumsrate.
Darauf folgt die Frage nach dem Zugriff: ob sequenziell oder random gelesen und geschrieben wird, ob einmalig oder wiederholt, in kleinen oder großen Transfers, mit wie vielen parallelen Clients und mit welcher Request Rate. Ebenso ist zu bestimmen, welche Schnittstelle die Anwendung tatsächlich benötigt — File über NFS oder SMB, eine S3-kompatible API, Block, NVMe beziehungsweise NVMe over Fabrics oder eine spezialisierte Datenbank- und Retrieval-Schnittstelle.
Schließlich ist relevant, wo sich das Compute befindet: im selben Server, im selben Rechenzentrum, an einem anderen Standort, in einer Cloud oder bei einem GPU- beziehungsweise NeoCloud-Provider. Erst aus der Kombination dieser Angaben ergibt sich der vollständige Datenpfad, und erst daraus lassen sich Bandbreite, Latenz, Parallelität sowie mögliche Anforderungen an Cache, Staging oder GPU-direkte Storage-Pfade ableiten.
10. Fazit
Es gibt keine einzelne Storage-Architektur, die für alle KI-Workloads optimal ist. Eine größere Unternehmensarchitektur besteht typischerweise aus mehreren Ebenen: den vorhandenen Unternehmensdaten in File- und Object-Systemen, einem persistenten AI-Datenbestand beziehungsweise Data Lake, einem Performance Tier mit Cache- und Staging-Funktion, einem leistungsfähigen Netzwerk und schließlich dem Compute mit seinen GPUs. Daneben besitzen RAG-Systeme, Vector Databases und andere spezialisierte Datenservices eigene Storage-Pfade.
Die entscheidende Architekturaufgabe besteht darin, Datenhaltung und Datenbereitstellung voneinander zu unterscheiden. Ein System, das Petabytes wirtschaftlich und dauerhaft speichert, muss nicht der optimale GPU-nahe Performance-Tier sein. Umgekehrt ist es weder wirtschaftlich noch technisch sinnvoll, sämtliche Roh- und historischen Daten dauerhaft auf dem Tier mit der niedrigsten Latenz vorzuhalten.
Die Storage-Frage für KI lässt sich damit nicht auf File oder Object, HDD oder Flash oder eine bestimmte IOPS-Zahl reduzieren. Der Workload bestimmt den Datenpfad, und der Datenpfad bestimmt die Storage-Anforderungen. Training verlangt hohen aggregierten Durchsatz, viele kleine Dateien oder Objekte erhöhen die Bedeutung von IOPS, Request Rate und Metadatenverarbeitung, Checkpointing erzeugt einen Write-Pfad, RAG kombiniert persistente Quelldaten mit spezialisierten Retrieval- und Indexstrukturen, und GPU-intensive Verarbeitung profitiert von kurzen und leistungsfähigen Datenpfaden.
Object Storage ist dabei insbesondere für große, unstrukturierte und S3-basiert zugängliche Datenbestände relevant. File Storage bleibt wichtig, wenn vorhandene Daten und Anwendungen File-Semantik benötigen. NVMe, Cache und Performance-Tiers überbrücken die Distanz zwischen persistentem Capacity Storage und Compute.
Entscheidend ist deshalb nicht, ein Storage-System mit dem Etikett „AI Storage" auszuwählen. Entscheidend ist, für jede Phase zu beantworten, welche Daten wann, in welcher Menge, über welche Schnittstelle und mit welcher Geschwindigkeit an welche Compute-Ressource gelangen müssen. Erst aus dieser Frage lässt sich eine belastbare Storage-Architektur für KI ableiten.
11. Quellen
Amazon Web Services: Performance guidelines for Amazon S3. Amazon S3 User Guide, Abschnitte „Scale storage connections horizontally" und „Use byte-range fetches". Abruf: 2. September 2026. https://docs.aws.amazon.com/AmazonS3/latest/userguide/optimizing-performance-guidelines.html
MLCommons: MLCommons Releases New MLPerf Storage v3.0 Benchmark Results. Pressemitteilung vom 1. September 2026. Abruf: 2. September 2026. https://www.globenewswire.com/news-release/2026/09/01/3354412/0/en/mlcommons-releases-new-mlperf-storage-v3-0-benchmark-results.html
MLCommons: Announcing the MLPerf Storage v2.0 Checkpointing Workload. Beitrag zur Aufnahme von Checkpointing als eigenständigem Benchmark-Workload, August 2025. Abruf: 2. September 2026. https://mlcommons.org/2025/08/storage-2-checkpointing/
MLCommons: MLPerf Storage. Benchmark-Übersicht mit Workload-Beschreibungen, Metrikdefinitionen und Vergleichbarkeitsregeln der v3.0-Runde, Stand 21. September 2026. Abruf: 2. September 2026.
https://mlcommons.org/benchmarks/storage/
NVIDIA: GPUDirect Storage Overview Guide, Release r1.18, 21. Mai 2026. NVIDIA Documentation. Abruf: 2. September 2026. https://docs.nvidia.com/gpudirect-storage/pdf/overview-guide.pdf
NVIDIA: GPUDirect RDMA and GPUDirect Storage. NVIDIA AI Enterprise Documentation, Version 8.2, Stand 17. August 2026. Abruf: 2. September 2026. https://docs.nvidia.com/ai-enterprise/release-8/latest/infra-software/vgpu/features/gpudirect.html
Scality: AI Data Path Between Storage and GPU — AIConnect. Herstellerdokumentation zur AIConnect-Architektur innerhalb von Scality ADI. Abruf: 2. September 2026. https://www.scality.com/technology-aiconnect
Scality: Enterprise AI for Core and Edge. Herstellerdokumentation zu den Workload-Gruppen der Scality-ADI-Architektur. Abruf: 2. September 2026. https://www.scality.com/use-cases/ai-core
Wasabi Technologies: Cloud Object Storage for AI. Herstellerdokumentation. Abruf: 2. September 2026. https://wasabi.com/solutions/ai
Welche Entscheidung steht bei Ihnen an?
Sie möchten eine bestehende Infrastruktur bewerten, eine neue Architektur planen oder eine konkrete technische Fragestellung klären? Sprechen Sie mit uns über Ihre Anforderungen.
Spezialist für moderne Dateninfrastruktur